Das KI-Playbook: 9 Denkmodelle fürs Bauen im Zeitalter der Intelligenz
Kurz gesagt: Eine Zusammenfassung von Andrej Karpathys 3,5-stündigem Talk über Large Language Models, aufbereitet als neun Lektionen für Gründer. Das Modell ist ein Token-Predictor, der das Internet simuliert. Produkte sollten also verifizieren, Tools nutzen und ihre Daten besitzen. Agents und Reinforcement Learning sind die Frontier, und Open Weights machen das Modell selbst zur Commodity.
Maschinelle Übersetzung aus English. Das Original ist die Referenz: Das Original lesen.
Auch verfügbar auf English.
Eine Zusammenfassung von Andrej Karpathys Vortrag über große Sprachmodelle, https://www.youtube.com/watch?v=7xTGNNLPyMI
Andrej Karpathy war Gründungsmitglied bei OpenAI und Director of AI bei Tesla, und viele nennen ihn den „Lehrer der KI-Revolution“. Er hat gerade einen dreieinhalbstündigen „State of the Union“ zu großen Sprachmodellen rausgehauen. Seine Message: Wenn du heute ein Startup baust, kommst du daran nicht vorbei. Das ist die neue Elektrizität.
Die meisten behandeln KI wie Magie. Karpathy behandelt sie als das, was sie ist: eine Maschine, die Tokens nach Wahrscheinlichkeit ausspuckt. Und genau das ändert verdammt viel daran, wie man baut.
Hier sind die 9 Takeaways für Gründer, die auf etwas bauen wollen, das sich gerade noch in Bewegung befindet.
Das Basismodell simuliert das Internet
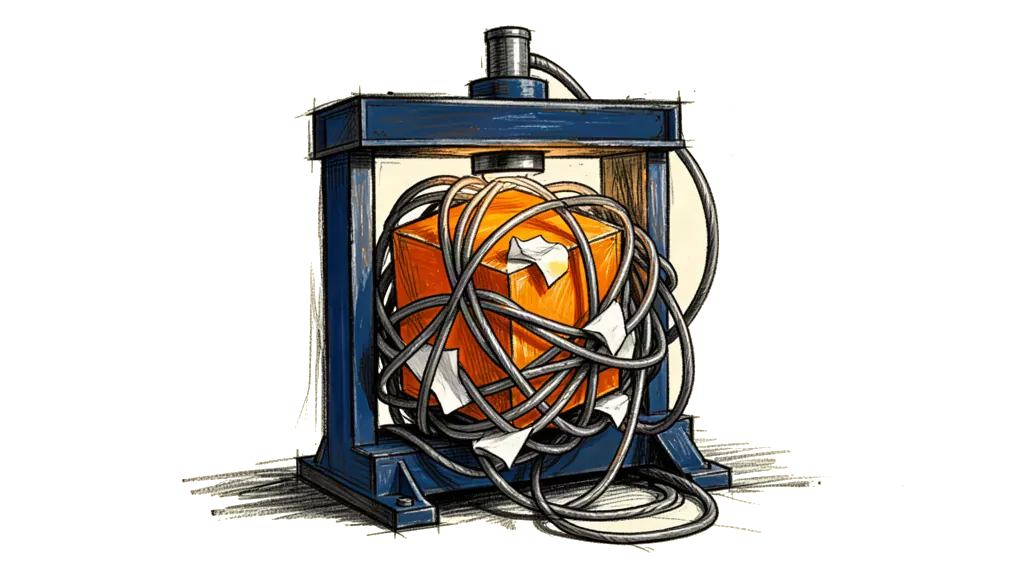
Erstens: Das Basismodell simuliert das Internet, es kennt keine Wahrheit. Gründer denken oft, die KI wisse alles. Tut sie nicht. Sie ist das Internet in komprimierter Form.
Karpathy erklärt, dass das Basismodell, also das rohe neuronale Netz, nur versucht, das nächste Wort eines beliebigen Internet-Dokuments vorherzusagen. Es will dir nicht helfen. Es will einen Reddit-Thread oder einen Wikipedia-Artikel simulieren [43:35].
Für Gründer heißt das: Das rohe Modell ist nicht dein Produkt. Dein Produkt ist das, was du obendrauf baust, um aus dem Simulator etwas Nützliches zu machen.
Fine-Tuning ist Rollenspiel
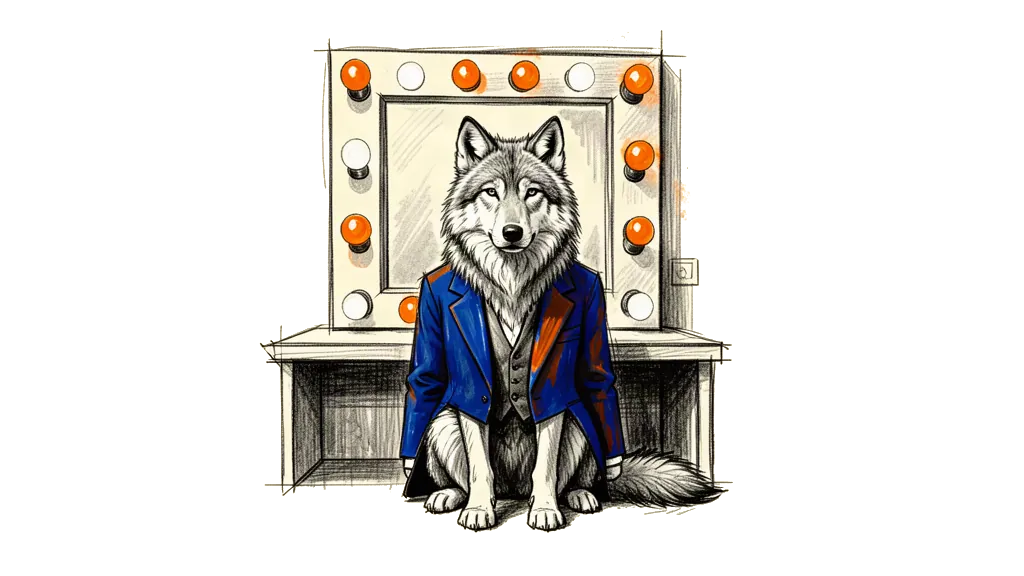
Zweitens: Fine-Tuning ist nichts als Rollenspiel. Wie wird aus einem wilden Internet-Simulator ein ChatGPT? Durch Supervised Fine-Tuning (SFT). Du bezahlst Leute dafür, Fragen und Antworten zu schreiben, und die KI lernt, sie nachzuahmen [01:03:00].
Wenn du also mit ChatGPT sprichst, sprichst du nicht mit einem Silizium-Gehirn. Du sprichst mit einer statistischen Simulation eines menschlichen Daten-Labelers [01:17:49].
Für Gründer heißt das: Fine-Tuning allein setzt deinem Startup eine harte Obergrenze, und die liegt auf menschlichem Niveau. Du wirst nie besser sein als deine Labeler.
Reinforcement Learning ist der AlphaGo-Moment
Drittens: Reinforcement Learning ist der AlphaGo-Moment. Hier passiert die eigentliche Frontier. Um über menschliches Niveau hinauszukommen, wie bei DeepSeek R1 oder OpenAI o1, brauchst du Reinforcement Learning (RL).
Karpathy zieht den Vergleich zu AlphaGo [02:42:20]. Trainierst du nur auf Spielen, die Menschen gespielt haben, bleibst du auf menschlichem Niveau stecken. Lässt du die KI aber gegen sich selbst spielen und belohnst Siege, findet sie „Move 37“, also Züge, auf die kein Mensch je gekommen wäre [02:45:32].
Für Gründer heißt das: Die wertvollsten Startups kopieren nicht nur Menschen. Sie bauen Gyms, also Umgebungen, in denen die KI trainieren und schlauer werden kann als wir.
Das Schweizer-Käse-Problem
Viertens: das Schweizer-Käse-Problem. Für Gründer ist das die kritischste Stelle. LLMs haben „Jagged Frontiers“.
Sie lösen Physikprobleme auf Doktorandenniveau und behaupten dann mit voller Überzeugung, dass 9,11 größer ist als 9,9 [02:05:40]. Warum? Weil 9,11 für den Token-Predictor aussieht wie ein Bibelvers oder ein Datum.
Für Gründer heißt das: Bau keine Produkte, die auf blindem Vertrauen beruhen. Bau Produkte, die verifizieren. Du brauchst einen Menschen oder Code in der Loop, der den Käse auf Löcher prüft.
Tokens zum Denken
Fünftens: Gib dem Modell Zeit auf dem Schmierblatt. Karpathy sagt, Modelle brauchen „Tokens zum Denken“ [01:58:00].
Wenn du ein Modell bittest, ein schweres Matheproblem in einem einzigen Wort zu lösen, scheitert es. Lässt du es aber die Schritte aufschreiben („Lass uns das Schritt für Schritt durchgehen...“), kriegt es das hin.
Für Gründer heißt das: Bau deine UX auf Geduld aus. Versteck die Wartezeit nicht, nutze sie. Lass das Modell eine Gedankenkette schreiben, bevor es die finale Antwort gibt.
Tools schlagen Gehirne
Sechstens: Tools schlagen Gehirne. Das Modell ist schlecht darin, „Strawberry“ zu buchstabieren und die Rs zu zählen, weil es Tokens sieht und keine Buchstaben [02:03:44].
Karpathys Antwort: Lass das LLM nicht im Kopf rechnen. Sag ihm, es soll ein Python-Skript schreiben, das die Buchstaben zählt.
Für Gründer heißt das: Hör auf, die KI zu zwingen, ein Computer zu sein. Computer haben wir schon. Bau Systeme, in denen die KI der Orchestrator in der Mitte ist, der Tools wie Suche, Taschenrechner oder Code aufruft, um die exakte Arbeit zu erledigen.
Halluzination ist ein Feature
Siebtens: Halluzination ist ein Feature, kein Bug. Halluzination ist einfach das Modell, das aus seinen Trainingsdaten träumt. Es passiert, weil das Modell mit Wahrscheinlichkeiten arbeitet und bei jedem Wort eine Münze wirft [26:45].
Du kannst das abmildern, indem du dem Modell erlaubst, „Ich weiß es nicht“ zu sagen, oder indem du Suche (RAG) nutzt, um die Antwort direkt in sein Arbeitsgedächtnis zu legen [01:35:00].
Für Gründer heißt das: Halluzinationen fixt du nicht in den Modellgewichten. Du fixst sie, indem du die richtige Antwort in den Prompt legst, also ins Kontextfenster.
Die Zukunft sind Agenten
Achtens: Die Zukunft gehört Agenten. Wir bewegen uns weg von Chatbots, die reden, hin zu Agenten, die handeln.
Karpathy erwartet, dass wir die Kontrolle an Modelle übergeben, die Tastatur und Maus bedienen und langfristige Aufgaben übernehmen [03:12:00].
Für Gründer heißt das: Die nächste Billionen-Dollar-Chance ist nicht „Chat with PDF“. Es ist „Mach meine Steuern“ oder „Buch meine Reise“, also der ganze Job von Anfang bis Ende.
Offene Gewichte holen auf
Neuntens: Offene Gewichte holen auf. Karpathy verweist auf DeepSeek und Llama [03:16:00]. Die Lücke zwischen den geschlossenen Modellen von OpenAI und Google und den offenen Modellen von DeepSeek und Meta schließt sich rasant.
Für Gründer heißt das: Das Modell selbst wird zur Commodity. Dein Moat ist nicht das LLM. Dein Moat sind deine eigenen Daten, deine Distribution und das Gym, das du baust, um deine Agenten zu trainieren.
Karpathys Schlusswort
Am Ende lässt Karpathy uns das hier mit:
„Du sprichst nicht mit einer magischen KI. Du sprichst mit einer statistischen Simulation eines durchschnittlichen menschlichen Labelers.“
Also bau mit diesem Wissen im Hinterkopf. Bete das Tool nicht an, benutz es einfach.